Les agents IA modernes accumulent des données dans leur contexte de discussion, mais apprennent-ils vraiment ? C’est la question à laquelle répond ReMe (Remember Me, Refine Me), un framework innovant développé par des chercheurs de l’Université Jiao Tong de Shanghai et d’Alibaba. Présenté dans un article récent (arXiv 2512.10696), ReMe transforme la façon dont les agents basés sur des modèles de langage (llm) gèrent leur mémoire et évoluent au fil du temps.
Les chercheurs derrière ReMe
Le framework ReMe est le fruit d’une collaboration entre des chercheurs de l’Université Jiao Tong de Shanghai et d’Alibaba Group, deux institutions majeures dans le domaine de l’intelligence artificielle en Chine.
L’équipe est menée par Hai Zhao, professeur au Département d’informatique de l’Université Jiao Tong de Shanghai. Zhao est un chercheur reconnu dans les domaines de l’IA, de l’AGI, des LLM et du NLP, avec plus de 12 000 citations à son actif. Il a obtenu son doctorat en logiciel et théorie informatique à l’Université Jiao Tong de Shanghai entre 2000 et 2005, et travaille depuis sur le traitement du langage naturel avec des passages notamment chez Microsoft Research Asia et à l’Université de Hong Kong.
Du côté industriel, Bolin Ding est un acteur clé de ce projet. Ding est directeur scientifique senior au sein du Data Analytics and Intelligence Lab (DAIL) d’Alibaba Group. Avant de rejoindre Alibaba en 2018, il était chercheur chez Microsoft Research, et a obtenu son doctorat en informatique à l’Université de l’Illinois à Urbana-Champaign sous la direction du professeur Jiawei Han. Ses recherches se concentrent sur l’utilisation de l’apprentissage automatique pour rendre les systèmes intelligents et efficaces, notamment les bases de données et les applications LLM.
Les autres co-auteurs incluent Zouying Cao, Jiaji Deng, Li Yu, Weikang Zhou, et Zhaoyang Liu, tous contribuant à différents aspects du framework, de la conception théorique à l’implémentation pratique.
Une publication récente
Le papier de recherche « Remember Me, Refine Me: A Dynamic Procedural Memory Framework for Experience-Driven Agent Evolution » a été soumis à arXiv le 11 décembre 2025. Cette publication récente témoigne de l’actualité des recherches sur la mémoire procédurale pour agents et s’inscrit dans un mouvement plus large visant à doter les systèmes d’IA de capacités d’apprentissage continu.
Le timing de cette publication est particulièrement pertinent : alors que les modèles de langage deviennent de plus en plus sophistiqués et sont déployés comme agents autonomes dans des environnements complexes, la question de leur capacité à apprendre et à évoluer de manière efficace devient cruciale. ReMe apporte une réponse concrète et mesurable à ce défi, comme en témoignent les résultats expérimentaux présentés dans l’article.
Le problème : des agents qui oublient tout à chaque fois
Imaginez un assistant qui, après quelques échanges, oublie et mélange la moitié des informations. C’est exactement ce qui se passe avec la plupart des agents IA actuels. Même quand ils disposent d’une mémoire, celle-ci fonctionne souvent comme une simple archive où l’on empile des informations sans jamais faire le tri. Résultat ? Un bric-à-brac d’expériences où le pertinent se noie dans l’obsolète.
Les systèmes existants souffrent de ce que les chercheurs appellent un « paradigme d’accumulation passive » : on stocke tout, on ne nettoie rien, et on espère que l’agent retrouvera la bonne information au bon moment. Spoiler : ça marche mal.
La solution ReMe : une mémoire qui vit et respire
ReMe change radicalement la donne en introduisant un cycle de vie complet pour la mémoire procédurale des agents. Au lieu d’une simple archive, on obtient un système vivant qui évolue en trois temps.
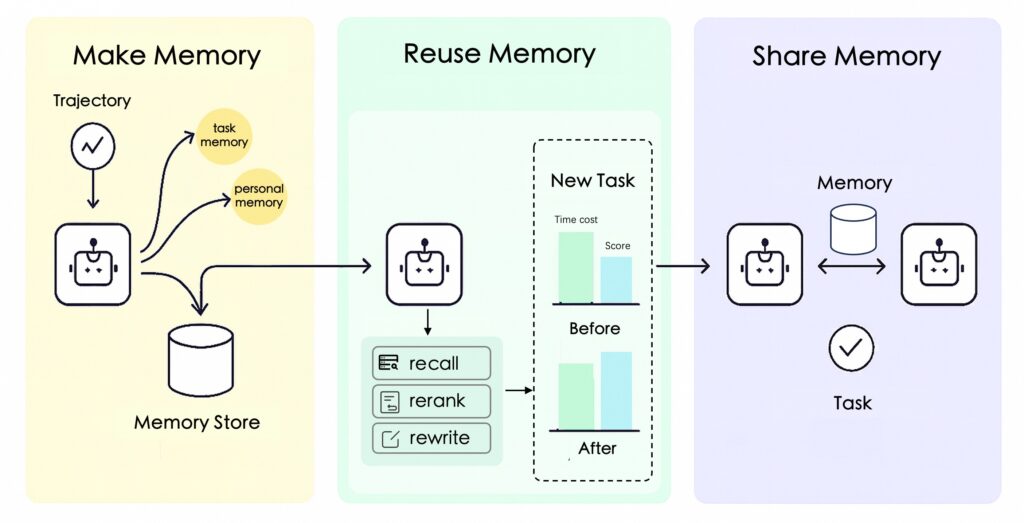
1. Distillation multi-facettes : extraire la substantifique moelle
Quand un agent réalise une tâche, ReMe ne se contente pas d’enregistrer ce qui s’est passé. Le système analyse en profondeur :
- Les patterns de succès : quelles stratégies ont fonctionné et pourquoi
- Les déclencheurs d’échec : quelles erreurs éviter, quels pièges anticiper
- Les insights comparatifs : qu’est-ce qui différencie vraiment une bonne approche d’une mauvaise
Cette analyse produit des expériences structurées, chacune comprenant un scénario d’utilisation, le contenu procédural, des mots-clés, un score de confiance et la liste des outils utilisés. Un mécanisme de validation vérifie ensuite que ces expériences sont réellement exploitables et pertinentes avant de les stocker.
2. Réutilisation adaptative : la mémoire qui s’adapte au contexte
Stocker des expériences ne suffit pas : il faut savoir les réutiliser intelligemment. C’est là que ReMe brille particulièrement.
Quand l’agent fait face à une nouvelle tâche, le système :
- Recherche les expériences pertinentes dans son pool via une indexation vectorielle
- Reclasse les candidats en fonction du contexte spécifique de la tâche actuelle
- Réécrit ces expériences pour les adapter précisément aux contraintes du moment
Cette dernière étape est cruciale : plutôt que de coller brutalement une ancienne expérience, ReMe la reformule pour qu’elle soit directement exploitable dans le nouveau contexte.
3. Raffinement basé sur l’utilité : le ménage intelligent
C’est peut-être l’aspect le plus innovant de ReMe. Au lieu d’accumuler indéfiniment, le système fait activement le tri :
- Ajout sélectif : seules les expériences vraiment utiles sont stockées. Les expériences montrent que stocker systématiquement les échecs pollue la mémoire, car un échec isolé fournit rarement assez de contexte pour une généralisation fiable.
- Réflexion sur l’échec : quand une tâche échoue, l’agent analyse ce qui n’a pas fonctionné et tente une nouvelle approche. Si cette seconde tentative réussit, la leçon apprise est intégrée en mémoire. Sinon, elle est simplement écartée.
- Suppression utilitaire : les expériences obsolètes ou de mauvaise qualité sont progressivement retirées, maintenant un pool compact et de haute qualité.
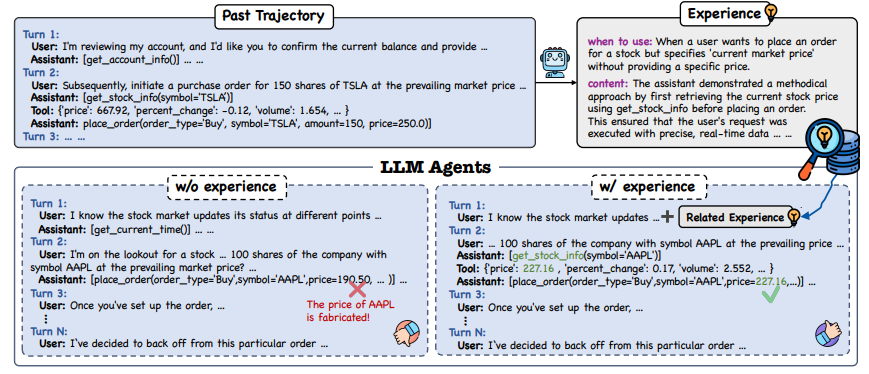
Ci-dessus un exemple illustrant comment les agents accomplissent une tâche de négociation boursière avec et sans expérience préalable.
Une architecture de mémoire complète
Au-delà de la théorie, ReMe est aussi un kit pratique qui organise la mémoire des agents en quatre types complémentaires :
Mémoire personnelle : comprendre et s’adapter aux préférences de l’utilisateur, avec une gestion temporelle des habitudes et du style d’interaction.
Mémoire de tâches : le cœur de ReMe, où réside le savoir-faire procédural réutilisable entre différents agents et contextes.
Mémoire d’outils : optimiser le choix et l’utilisation des outils en suivant les taux de succès, les temps d’exécution et les coûts, transformant progressivement les descriptions d’outils en véritables manuels vivants.
Mémoire de travail : gérer le contexte à court terme avec des mécanismes d’offload/reload pour éviter de surcharger le contexte de l’agent lors de tâches longues.
Des résultats qui parlent d’eux-mêmes
Les expériences menées sur les benchmarks BFCL-V3 et AppWorld révèlent l’efficacité de l’approche. Le modèle Qwen3-8B équipé de ReMe obtient un score moyen de 34,94 et un taux de passage de 55,03, là où le même modèle sans mémoire plafonne à 27,65 et 46,20 respectivement.
Mais le résultat le plus impressionnant est ailleurs : Qwen3-8B avec ReMe surpasse Qwen3-14B sans mémoire. Autrement dit, un modèle plus petit doté d’une mémoire intelligente bat un modèle 75% plus gros qui repart de zéro à chaque tâche. C’est ce que les chercheurs appellent le « memory scaling effect » : la mémoire procédurale compense la taille du modèle en permettant un apprentissage plus efficace.
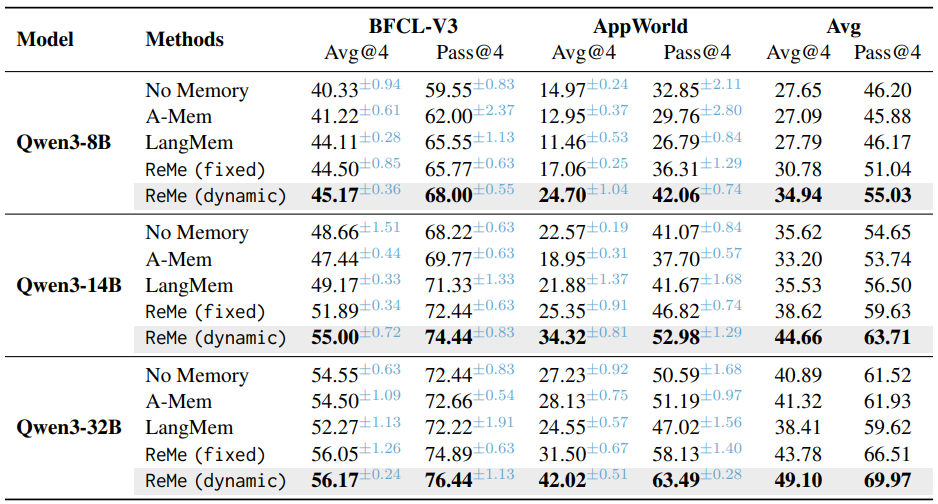
ReMe se montre également supérieur à d’autres systèmes de mémoire pour agents comme A-Mem et LangMem, démontrant l’intérêt de sa gestion dynamique et de ses mécanismes d’adaptation au contexte.
Comment ça marche en pratique ?
Le kit ReMe est conçu pour être modulaire et facile à intégrer. Un cycle typique d’utilisation ressemble à ceci :
- Avant une tâche : l’agent recherche des expériences pertinentes, récupère les préférences utilisateur et choisit ses outils guidé par son historique
- Pendant l’exécution : la mémoire de travail gère les gros contextes via des mécanismes d’offload
- Après l’exécution : distillation de nouvelles expériences, ajout sélectif au pool, éventuellement nettoyage des anciennes expériences
Le système supporte différents backends vectoriels (Elasticsearch, ChromaDB) et s’intègre avec les frameworks d’agents existants. Le projet est open-source et inclut même une bibliothèque d’expériences pré-construites (reme.library) pour démarrer rapidement.
Les limites à garder en tête
Comme toute innovation, ReMe n’est pas une solution miracle. Quelques points d’attention :
- La qualité de la mémoire dépend fortement de la qualité des modèles utilisés pour la distillation et le reclassement
- Il faut gérer la complexité de recherche quand le pool d’expériences grandit
- Le système nécessite une vigilance sur la cohérence temporelle et les possibles dérives si de mauvaises expériences s’accumulent
ReMe se concentre aussi sur la mémoire non-paramétrique : il n’ajuste pas les paramètres du modèle lui-même, mais enrichit son contexte avec des expériences externes.
Vers des agents qui apprennent vraiment
ReMe représente un changement de paradigme dans la conception des agents IA. En passant d’une accumulation passive à une mémoire active et auto-évolutive, le framework ouvre la voie à des agents capables d’un véritable apprentissage continu.
L’idée centrale est simple mais puissante : pour qu’un agent devienne vraiment intelligent, il ne suffit pas qu’il accumule des données. Il doit savoir distiller des leçons de son expérience, les adapter à de nouveaux contextes et faire le tri entre ce qui reste pertinent et ce qui ne l’est plus. Exactement comme nous le faisons, humains, tout au long de notre vie.
Le code source de ReMe et la bibliothèque d’expériences pré-construites sont disponibles sur GitHub. L’article complet peut être consulté sur arXiv (2512.10696).
Laisser un commentaire